
MLOps Consulting: Gids voor betrouwbare ML-pijplijnen en monitoring
De MLOps-markt zal naar verwachting groeien van 4,39 miljard USD in 2026 naar 89,91 miljard USD in 2034, met een samengestelde jaarlijkse groei van 45,8% over die periode (Fortune Business Insights). Die groei verandert de vraag van "Moeten we machine learning operationeel maken?" naar "Hoe houden we ML betrouwbaar als het eenmaal in productie is?"
Daar komt MLOps-consulting om de hoek kijken. Het is de kunst om prototypes om te zetten in systemen die echte pieken in verkeer, veranderende data, audits en overdrachten tussen data science, engineering en operations kunnen doorstaan. In de praktijk overbruggen consultants de kloof tussen experimenteren met modellen en productiediscipline, vooral wanneer organisaties worstelen met gefragmenteerde tools, handmatige implementatiestappen en zwakke monitoring.
Een sterk consultancy-traject begint niet met een lijst van tools. Het begint met de volledige levenscyclus: data-ingestie, feature-creatie, training, implementatie, observability, rollback en governance. De beste consultants helpen teams om herhaalbare workflows op te zetten, geen demonstraties die instorten bij de eerste verkeersschommeling of modeldrift.
Inhoudsopgave
- Inleiding tot MLOps-consulting
- Waarom MLOps-consulting nu belangrijk is
- Kerncomponenten van MLOps-consulting
- Het ontwerpen van betrouwbare ML-pijplijnen en herleidbare workflows
- Het implementeren van productiemonitoring en modeloperaties
- Rendement op investering met MLOps-consulting
Inleiding tot MLOps-consulting
Een bedrijf kan een model hebben dat er uitstekend uitziet in een notebook en toch faalt zodra het wordt blootgesteld aan productieverkeer. Het probleem is meestal niet het algoritme, maar het operationele pad eromheen. MLOps-consulting bestaat om dat pad te ontwerpen zodat het model kan worden getraind, geïmplementeerd, gemonitord en bijgewerkt zonder dat elke release een crisissessie wordt.
Wat consultants daadwerkelijk oplossen
Het werk begint meestal met een eenvoudige maar ongemakkelijke beoordeling. Waar komen gegevens vandaan, wie is verantwoordelijk voor de pijplijn, hoe worden modelversies bijgehouden en wat gebeurt er als een voorspelling fout gaat? In veel organisaties zijn die antwoorden verspreid over teams en tools. Daarom richten consultants zich op het creëren van één operationeel model dat engineering, data science, beveiliging en platformoperaties met elkaar verbindt.
Dat kan betekenen: het opzetten van implementatieworkflows, het definiëren van normen voor herleidbaarheid, of het creëren van governance rondom de vraag wanneer een model van test naar live verkeer kan. Het kan ook betekenen: teams helpen beslissen wat geautomatiseerd moet worden, wat handmatig moet worden beoordeeld en wat een expliciet rollback-pad nodig heeft.
Praktische regel: als een team niet kan uitleggen hoe een model van trainingsdata naar een live endpoint gaat, heeft het nog geen MLOps-proces, maar een verzameling scripts.
Waarom de consultancy-invalshoek ertoe doet
Consulting voegt waarde toe wanneer de bottleneck niet alleen de modelkwaliteit is. De frictie zit meestal in overdrachten, omgevingsdrift, versieverschillen, zwakke traceerbaarheid en onduidelijk eigenaarschap na de lancering. Het doel is niet alleen om sneller te leveren, maar om elke lancering veiliger en gemakkelijker te beheren.
Daarom verschilt MLOps-consulting ook van algemene data science-hulp. Een consultant die verstand heeft van AI in productie zal vragen stellen over logging, incidentrespons, evaluatiepoorten, serviceniveau-metrics en hoe een model zich gedraagt wanneer de onderliggende data verandert. Die vragen klinken operationeel, omdat ze dat ook zijn.
Waarom MLOps-consulting nu belangrijk is
Het marktsignaal is moeilijk te negeren. De MLOps-markt zal naar verwachting snel groeien, wat laat zien dat organisaties machine learning-operations niet langer als een experiment behandelen. Ze begroten voor de systemen, controles en routines die modellen na implementatie betrouwbaar houden.
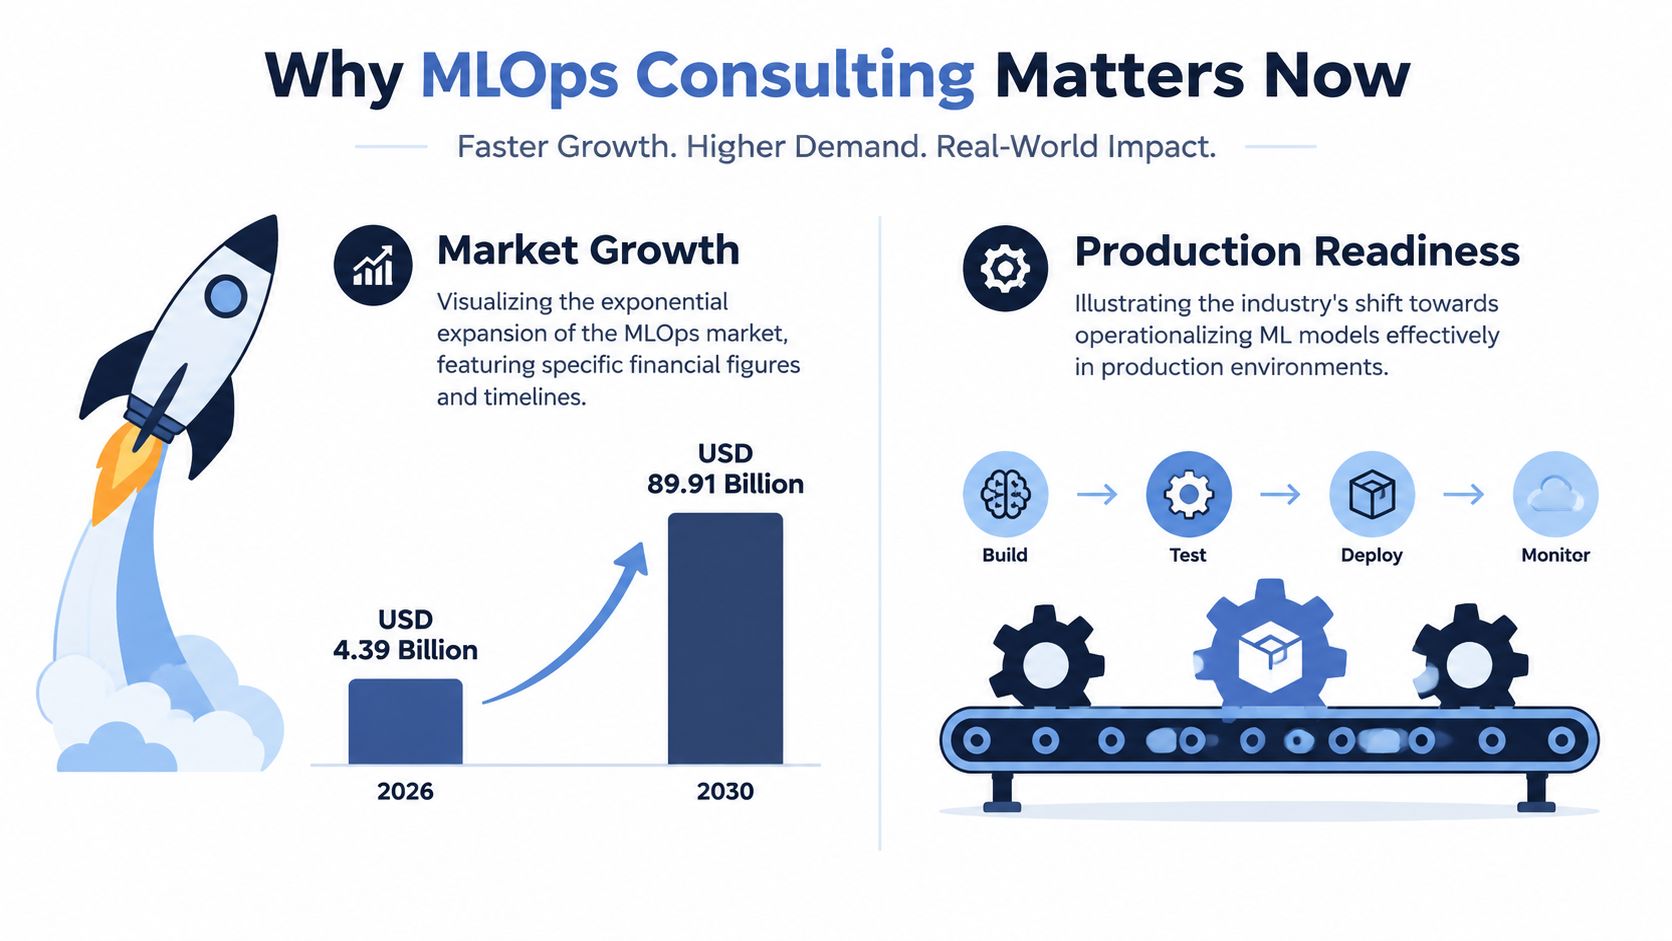
De markt verschoof van niche naar operationeel budget
De verschuiving werd zichtbaar in het begin van de jaren 2020, toen modeloperaties als een aparte bedrijfsfunctie op de kaart kwamen te staan in plaats van als een informele engineeringgewoonte (Mordor Intelligence). Dat is belangrijk omdat kopers een bredere vraag begonnen te stellen: ze willen weten of de hele levenscyclus kan worden beheerd met dezelfde discipline als productiesoftware.
Hetzelfde rapport wijst op de pijnpunten die die verandering hebben veroorzaakt:handmatige modelimplementatie, gefragmenteerde MLOps-tools, lage automatiseringsgraad van de modellevenscyclus en onvoldoende modelmonitoring. Die hiaten zijn niet cosmetisch. Ze leiden tot vertraagde releases, moeilijk traceerbare fouten en modellen die zich in tests goed gedragen maar in de praktijk afdwalen.
Waarom productiebereidheid budget wint
Wanneer ML naar productie gaat, verandert het werk. Teams hebben herhaalbare implementatiestappen nodig, governance die onder druk blijft werken en monitoring die stille fouten opmerkt vóór klanten dat doen.
Daarom richt consulting zich vaak op de volledige operationele levenscyclus en niet alleen op de keuze van tools. Een goede consultant helpt bij het in kaart brengen van overdrachten, het aanscherpen van evaluatiepoorten en het definiëren van wat er gebeurt wanneer modelgedrag na de lancering verandert. Architectuur met hoge beschikbaarheid, evaluatiepijplijnen en cloudmodernisering zijn allemaal belangrijk omdat ze operationele hiaten dichten die direct invloed hebben op ROI. Als een model niet kan worden ondersteund, geobserveerd en gecorrigeerd in productie, blijft de bedrijfswaarde theoretisch.
Kerncomponenten van MLOps-consulting
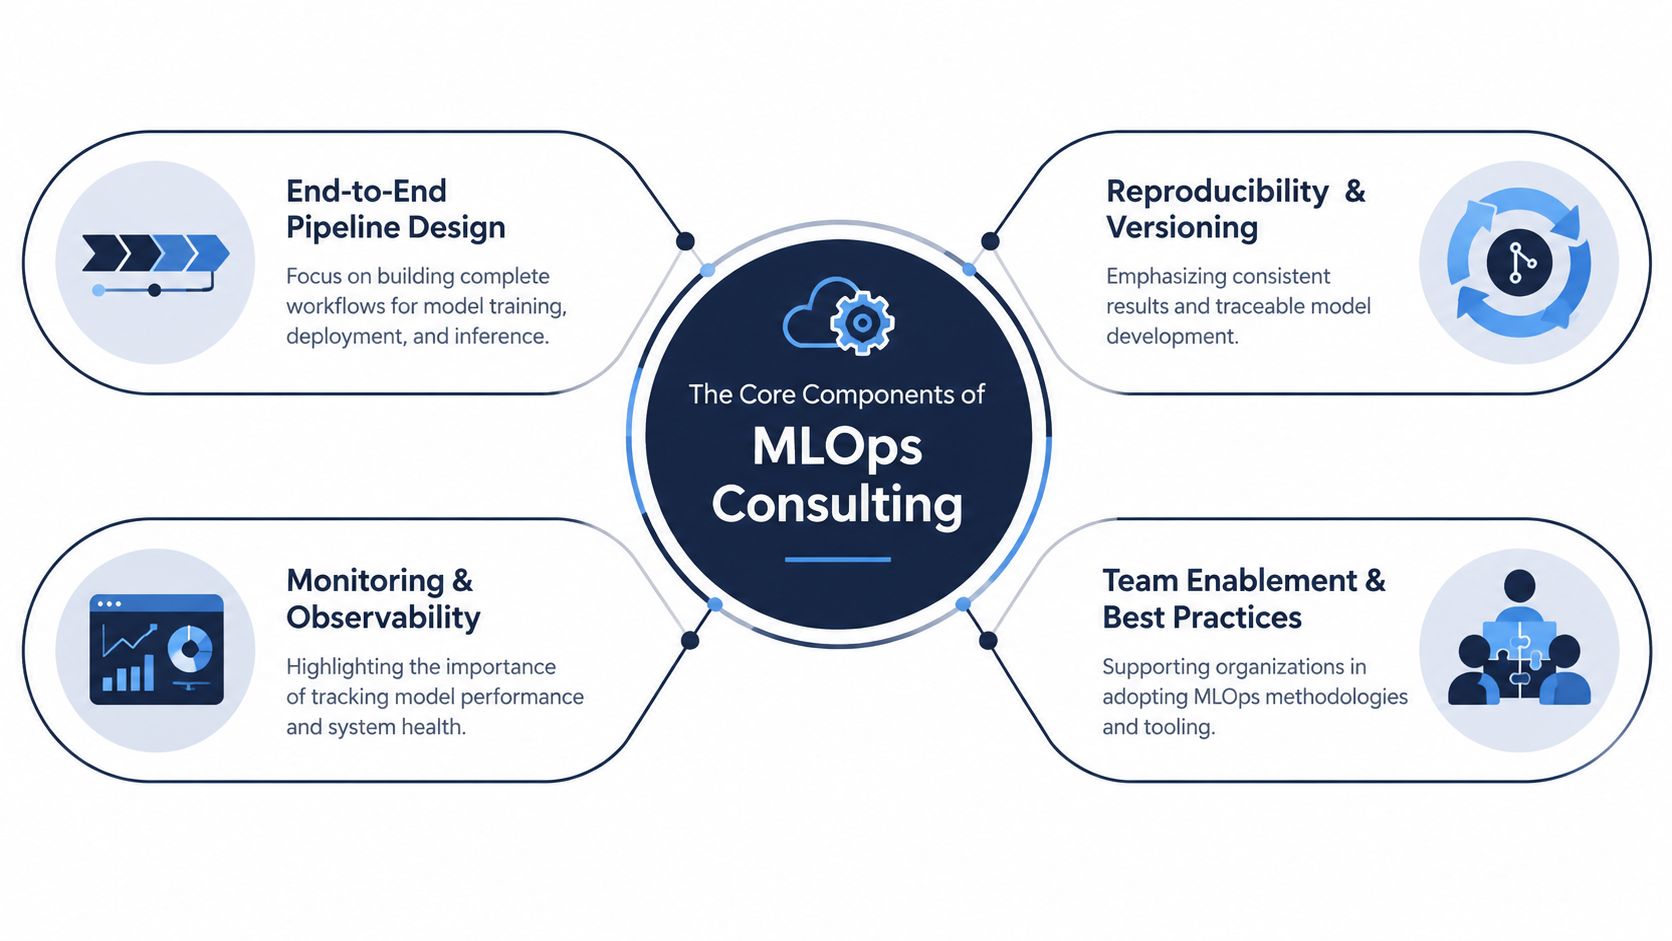
De meeste trajecten vallen uiteen in vier samenhangende capabilities. Door ze als afzonderlijke werkstromen te behandelen ontstaan meestal hiaten, want een model kan niet betrouwbaar zijn als de pijplijn breekbaar is, en monitoring kan niet helpen als niemand kan herleiden wat er is veranderd.
End-to-end pijplijnontwerp
Consultants brengen eerst de route van data naar voorspelling in kaart. Dat omvat ingestie, feature-engineering, training, validatie, implementatie en inferentie. Het belangrijkste is niet alleen automatisering, maar ook dat elke stap zichtbaar genoeg is zodat teams kunnen vaststellen waar een storing is begonnen.
Herleidbaarheid en versiebeheer
Een model zonder traceerbaarheid is moeilijk te vertrouwen en nog moeilijker te herstellen. Consultants introduceren meestal artefactversiebeheer, experimentregistratie en CI/CD-integratie zodat code, data en modeloutputs aan elkaar gekoppeld blijven. Dat maakt het mogelijk om later basale vragen te beantwoorden, zoals welke dataset een geïmplementeerd model heeft getraind, of welke configuratie een slechte release heeft veroorzaakt.
Monitoring en observability
Fouten in productie-ML kunnen subtiel zijn. De service kan geldig lijkende outputs blijven retourneren, zelfs wanneer voorspellingen fout zijn. Daarom moet monitoring inputs, outputs, actuele waarden en driftsignalen vastleggen. De observability-stack moet het mogelijk maken om modelregressies snel te onderscheiden van infrastructuurfouten.
Teambekwaamheid en operationele gewoonten
De laatste laag is vaak het minst glamoureus en het belangrijkst. Teams hebben een gedeelde taal nodig voor rollout, hertraining, eigenaarschap en incidentafhandeling. Consultants laten vaak operationele patronen, beslissingsregels en reviewpraktijken achter, omdat tools alleen onduidelijke verantwoordelijkheden niet oplossen.
De echte waarde ontstaat wanneer de organisatie het systeem kan draaien zonder heldhaftige inspanningen van één specialist.
Een sterk traject optimaliseert niet één vak in de stack. Het verbindt alle vier zodat het platform, de mensen en het releaseproces elkaar versterken in plaats van uit elkaar te trekken.
Het ontwerpen van betrouwbare ML-pijplijnen en herleidbare workflows
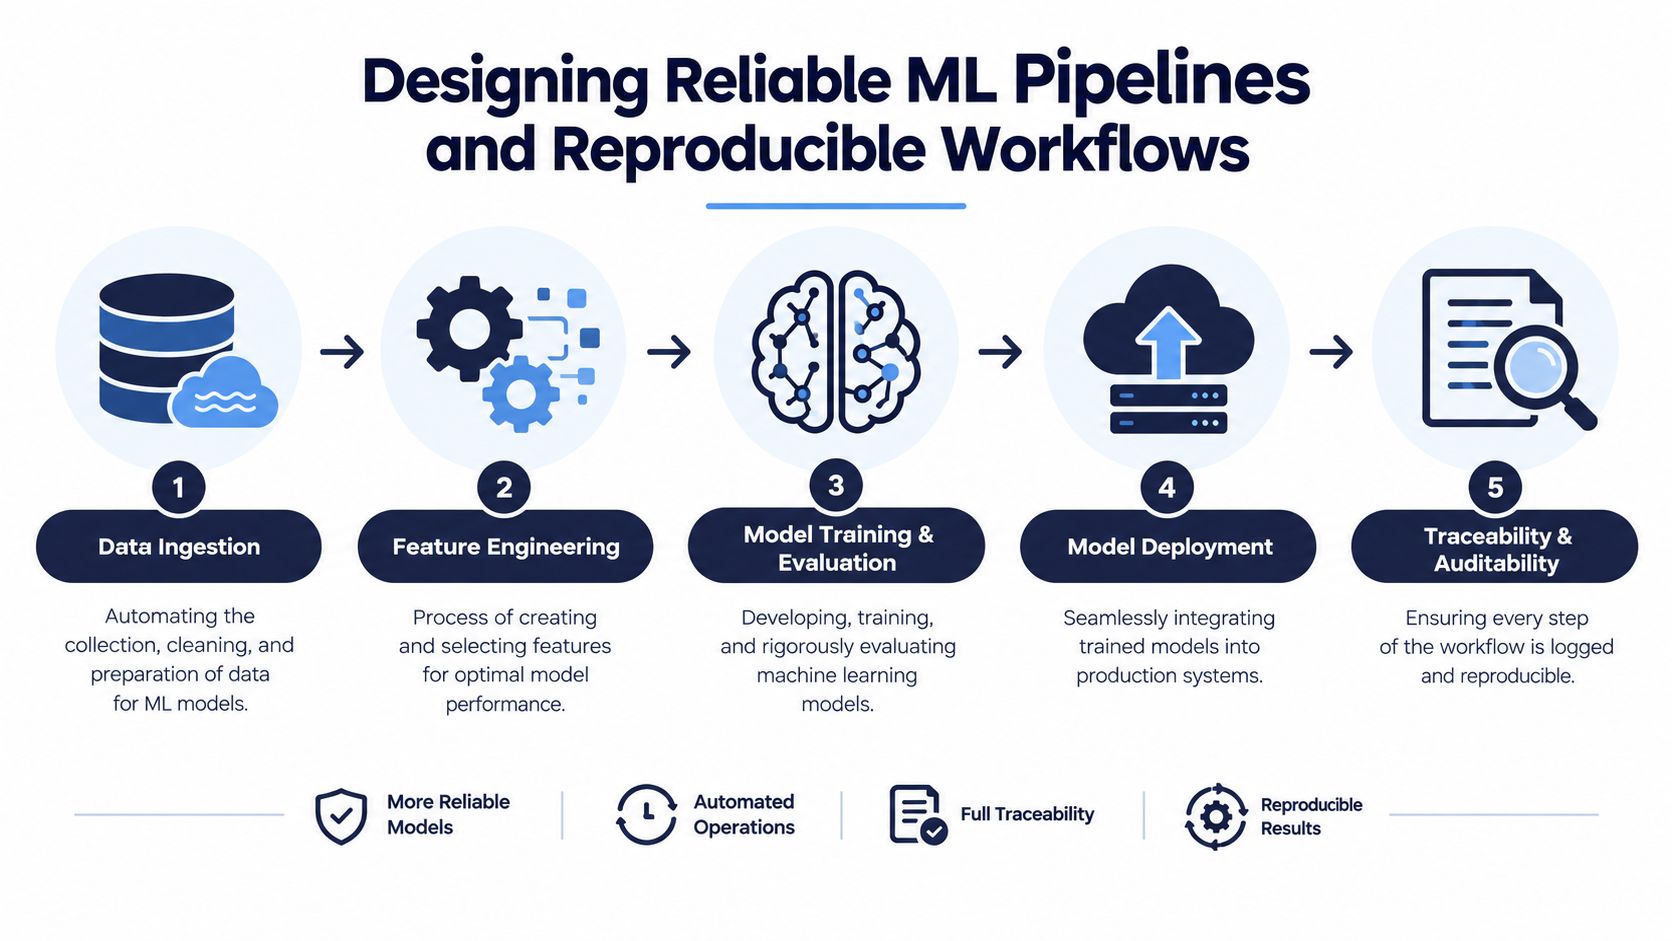
Betrouwbare ML-pijplijnen zijn opzettelijk voorspelbaar. Ze doorlopen elke keer hetzelfde pad voor data, training en release, zodat teams kunnen zien waar een fout begint in plaats van achteraf te raden. Dat is belangrijk omdat ad-hocscripts kunnen blijven werken totdat een afhankelijkheid verandert, een dataset verschuift of de runtime-omgeving afwijkt.
Begin met het pad, niet de tool
Consultants beginnen gewoonlijk met het in kaart brengen van de volledige operatiereeks. Ze definiëren welke data wordt ingenomen, hoe die wordt opgeschoond, waar features worden gecreëerd, hoe training wordt getriggerd en hoe het model de productie bereikt. Zodra die stroom zichtbaar is, kan het team beslissen welke delen in gecontaineriseerde jobs thuishoren, welke via CI/CD worden georkestreerd en welke in een registry worden bijgehouden.
Maak elk artefact traceerbaar
Herleidbaarheid hangt af van het intact houden van de bewijsketen. Datasets, modelbinaries, configuratiebestanden en evaluatieresultaten moeten allemaal samen worden geversied. Infrastructuur-as-code helpt ook, omdat het runtimeomgevingen kan recreëren in plaats van ze uit het geheugen te reconstrueren.
Deze aanpak past ook bij concreet leveringswerk, zoals dit platformleveringsproject, waar traceerbaarheid en operationele duidelijkheid vormgeven aan hoe het systeem wordt gebouwd en overgedragen.
Houd de workflow inspecteerbaar
Een pijplijn die niet kan worden gecontroleerd wordt een risico in gereguleerde of high-availability-omgevingen. Consultants raden vaak aan om elke run te loggen, evaluatie-outputs op te slaan en promotiecriteria expliciet te maken. Als een model wordt gepromoot, moet het team weten waarom. Als het wordt afgewezen, moet het team weten wat er misging.
Het gaat niet alleen om automatisering. Het gaat erom elke stap zo zichtbaar te maken dat een andere engineer de run kan reproduceren, de outputs kan beoordelen en het werk kan voortzetten zonder de stack vanaf nul op te bouwen.
De beste workflows maken overdrachten voorspelbaar. Als een data scientist vertrekt, moet een andere engineer nog steeds hetzelfde pad kunnen volgen, de artefacten kunnen inspecteren en het systeem met vertrouwen kunnen doorontwikkelen.
Het implementeren van productiemonitoring en modeloperaties
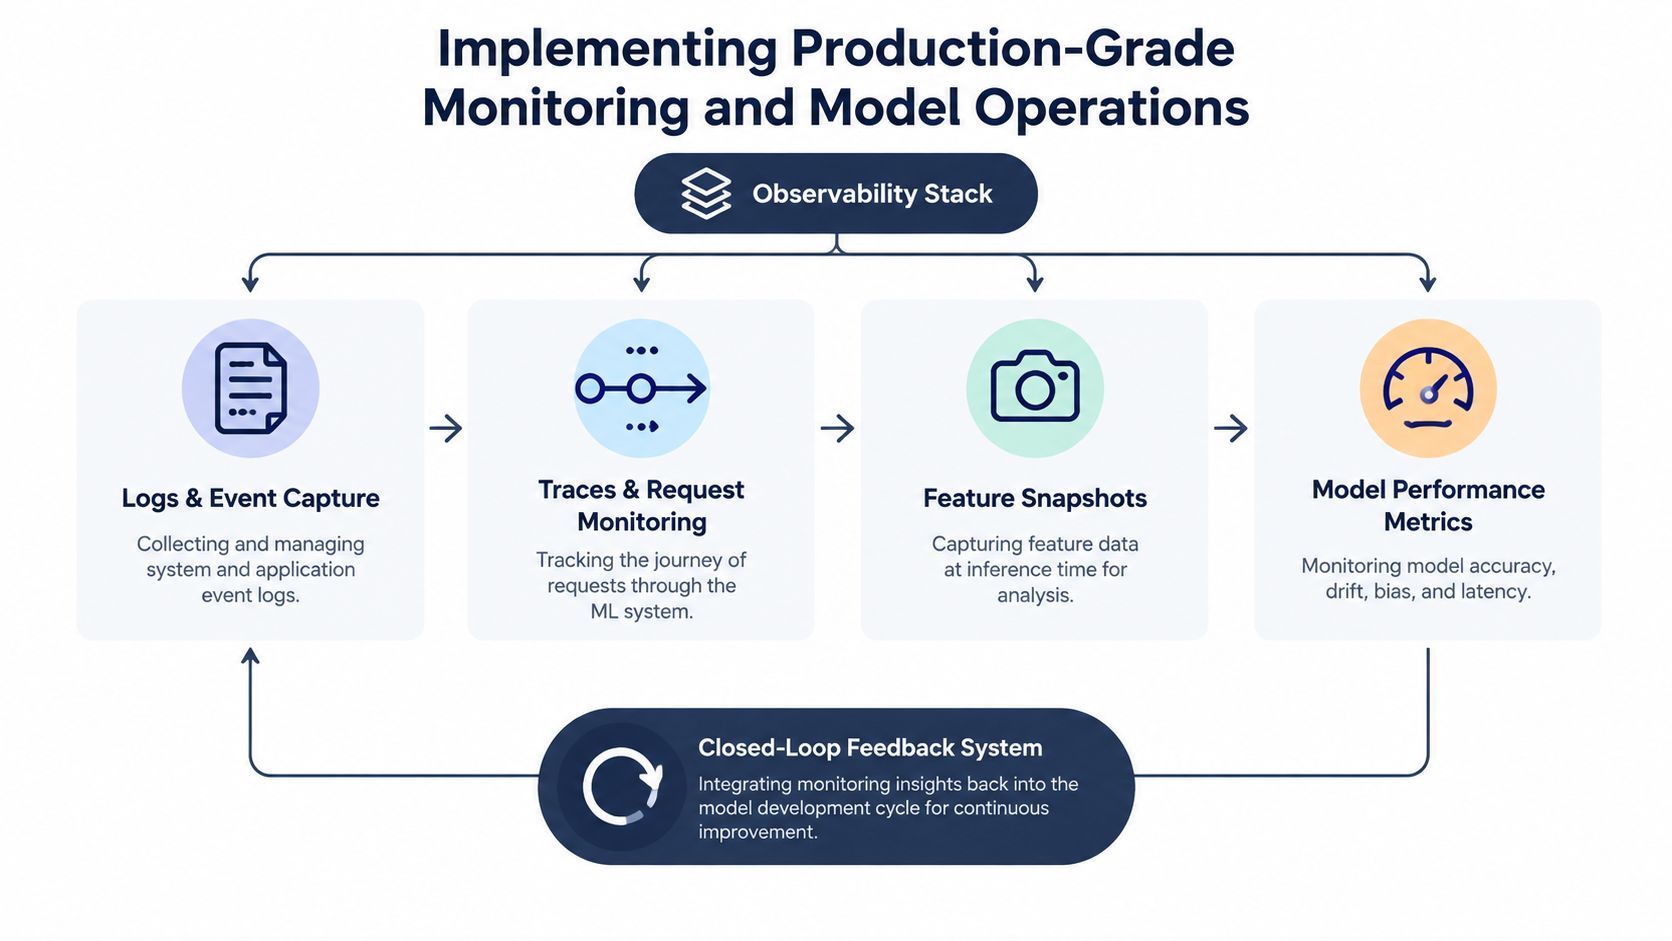
Monitoring is waar veel ML-projecten ofwel betrouwbare diensten worden, ofwel vervallen. Een dashboard alleen is niet genoeg, want een dashboard toont alleen een momentopname. Echte monitoring vergelijkt productiegedrag met een basislijn en vertelt engineers wanneer het systeem is afgedwaald, teruggevallen of begint te falen onder verkeersdruk.
Bouw de observability-stack in lagen
Consultants starten meestal met logs, traces en verzoekmonitoring. Daarna voegen ze feature-snapshots, voorspellingsregistraties en modelprestatiemetrics toe, zodat het team kan afstemmen wat het model zag met wat het produceerde. Die gelaagde benadering is belangrijk omdat het helpt om dataproblemen te onderscheiden van serviceproblemen en modelgedragsproblemen.
Gebruik feedbacklussen, geen statische weergaven
Een productiemonitoringsysteem moet live data vergelijken met trainingsdata of recente productiebasislijnen en vervolgens alarm slaan wanneer drempelwaarden worden overschreden (KodeKloud). Dat ontwerp is nuttiger dan een eenmalig rapport, omdat het engineeringteams in staat stelt om te reageren terwijl het probleem nog beperkt is.
Operationele waarheid: stille fouten zijn de moeilijkste fouten in ML, omdat het endpoint blijft antwoorden ook al worden de antwoorden steeds slechter.
Verbeter de relatie tussen model- en servicehealth
Alleen modelmetrics vertellen niet het hele verhaal. Latentie, foutpercentages en doorvoer zijn belangrijk omdat gebruikers de hele dienst ervaren, niet alleen de voorspellingsengine. In gereguleerde of kritieke systemen definiëren consultants ook fallback-gedrag, gefaseerde overgangen en escalatiepaden, zodat de dienst bruikbaar blijft terwijl het model wordt onderzocht.
Voor teams die kijken naar aangrenzende architectuurkeuzes, is deze multi-LLM stackreferentie een nuttige herinnering dat AI in productie meestal duidelijke routering, observability en fallback-denken nodig heeft, niet alleen modeltoegang.
Het doel is simpel. Wanneer er iets verschuift, moet het team weten of het moet hertrainen, terugdraaien of infrastructuuronderzoek moet doen vóórdat een klant het merkt.
Rendement op investering met MLOps-consulting
Het ROI-verhaal is het sterkst wanneer je kijkt naar incidentafhandeling, niet alleen naar lanceringssnelheid. Effectieve monitoring die inputs, voorspellingen, actuele waarden en drift vastlegt, kan de tijd van anomaliedetectie tot root-cause-analyse met meer dan 50% verminderen (Deepak Karkala). Dat is belangrijk omdat elke minuut besteed aan het zoeken naar de oorzaak van een slechte voorspelling kosten, risico en onzekerheid toevoegt.
Waar de bedrijfswaarde zichtbaar wordt
Een betere observability-stack verkort de diagnose tijd, wat downtime verkort en de omvang van slechte releases beperkt. Het helpt teams ook om te beslissen wanneer ze moeten hertrainen, wanneer ze moeten terugdraaien en wanneer het probleem stroomopwaartse datakwaliteit is in plaats van een modeldefect. Dat is de soort duidelijkheid waar leidinggevenden voor betalen, omdat het operationele verspilling en klantimpactvolle fouten vermindert.
De grotere ROI komt van het verminderen van handmatig werk. Wanneer implementatie, monitoring en rollback zijn gestandaardiseerd, besteden engineeringteams minder tijd aan het opnieuw uitvinden van releasemechanismen en meer tijd aan het verbeteren van het product. Zo houden organisaties ook de eenheidseconomie onder controle als het gebruik groeit.
Waarom het consultancytarief zich snel terugverdient
Een consultancy verkoopt geen dashboard, maar een veiliger operationeel model. Dat model kan dure misstarts voorkomen, het aantal mensen dat bij elk incident wordt betrokken verminderen en het eigenaarschap van modellen over teams heen verduidelijken. Wanneer AI-systemen bedrijfskritisch worden, wegen die besparingen zwaarder dan de nieuwigheid van het model zelf.
Voor een praktijkvoorbeeld van dit soort toegepaste engineersfocus, zie dit AI- en softwareleiderschapswerk, dat dezelfde nadruk op productiebereidheid en operationele discipline weerspiegelt.
Als een model belangrijk genoeg is om invloed te hebben op omzet of risico, is het belangrijk genoeg om te monitoren zoals productiesoftware.
Het kortste pad naar ROI is meestal geen mooier model. Het is een systeem dat minder vaak faalt, zichtbaarder faalt en sneller herstelt.